Thông tin chung
- Tạo GitHub repo riêng cho nhóm, để ở chế độ riêng tư (private), và mời tất cả thành viên trong nhóm vào làm cộng tác viên (collaborators).
-
Chia sẻ quyền đọc
(read access) với account GitHub của giảng viên:
@tuanphong-uet(Phong),daovietanh190499(Việt Anh),ptdu-uet(Du),20020054-spm(Huỳnh). - Điền link repo vào spreadsheet ở phía trên.
- GitHub repo đầy đủ (mã nguồn, dữ liệu thô và đã xử lý, báo cáo) và
README hướng dẫn chạy lại, có
requirements.txtliệt kê thư viện đã dùng. - Xem thêm thông tin tại mục Sản phẩm cần bàn giao.
Tổng quan về dữ liệu
Giới thiệu
Vastopolis Epidemic là bộ dữ liệu trong Mini Challenge 1 của cuộc thi IEEE VAST 2011, dữ liệu bao gồm dữ liệu về Thời tiết (kiểu hình thời tiết, thời gian, tốc độ gió trung bình, hướng gió) và dữ liệu về các Microblogs (nội dung blog, thời gian đăng tải, vị trí đăng tải) do các cư dân thành phố Vastopolis đăng tải. Dữ liệu có định dạng CSV.
Thành phố Vastopolis đã xảy ra một đại dịch lớn (vẫn chưa rõ là đại dịch nào) và nguyên nhân vẫn chưa được nắm rõ (có thể do khủng bố). Bằng việc phân tích dữ liệu về Thời tiết theo ngày và microblogs theo phút của mỗi cư dân, tìm cách kết nối thông tin về Thời tiết và thông tin về microblogs, từ đó đại dịch có thể được truy vết để tìm ra đại dịch nào đang xảy ra, thời điểm bùng phát, nơi bùng phát, nguyên nhân lan truyền dịch bệnh, nơi chịu tổn hại nhiều nhất và nguyên nhân gây ra đại dịch.
Trang tải dữ liệu: Google Drive - Vastopolis Epidemic Dataset (dùng VNU account để tải).
Phạm vi dữ liệu
Tất cả các nhóm sử dụng dữ liệu Thời tiết và microblogs để phân tích tình hình đại dịch cho thành phố Vastopolis. Mỗi nhóm tự tách dữ liệu về thời tiết và microblogs của mình theo khoảng thời gian được phân công như bên dưới.
Mỗi nhóm sẽ được phân công 04 ngày dữ liệu (theo bảng phân công trong spreadsheet).- Nhóm 2.1: Dữ liệu thời tiết + microblogs từ ngày 30/4 - 3/5.
- Nhóm 2.2: Dữ liệu thời tiết + microblogs từ ngày 4/5 - 7-5.
- Nhóm 2.3: Dữ liệu thời tiết + microblogs từ ngày 8/5 - 11/5.
- Nhóm 2.4: Dữ liệu thời tiết + microblogs từ ngày 12/5 - 15/5.
- Nhóm 2.5: Dữ liệu thời tiết + microblogs từ ngày 16/5 - 20/5.
Mục tiêu
- Thành thạo nạp/ghi dữ liệu lớn (CSV) và tổ chức thư mục làm việc.
- Rèn luyện làm sạch, chuẩn hoá, tạo đặc trưng bằng Python, NumPy, Pandas.
- Thực hành trực quan hoá bằng Matplotlib/Seaborn/Wordcloud.
- Thực hành trực quan hoá dữ liệu GIS (thông tin địa lý) lên bản đồ.
- Nâng cao kỹ năng tổng hợp & diễn giải dữ liệu thực tế; báo cáo minh bạch.
Công việc cần thực hiện
0) Khởi tạo dự án & GitHub repo
Yêu cầu chung: Tạo GitHub repo riêng cho nhóm (private); mời giảng viên làm collaborator.
-
Tạo repo mới trên GitHub, đặt tên rõ ràng (ví dụ:
2526-LTXLDL-Project-<Tên-Nhóm>). - Mời giảng viên làm collaborator với quyền đọc (read access).
- Điền link repo vào spreadsheet phân công nhóm. Hạn cuối: trước 23:59:59, ngày 10/11/2025.
1) Thu thập & tổ chức dữ liệu
Yêu cầu chung: Tải đủ dữ liệu về Thời tiết và microblogs của thành phố Vastopolis.
Dữ liệu thô cần tải về từ trang chính thức, bao gồm:
- Tệp CSV về microblogs.
- Tệp CSV về Thời tiết.
- Tệp CSV về dân số của mỗi khu vực trong thành phố Vastopolis.
- Tệp CSV tổng hợp các từ khóa phổ biến trong các blogs của cư dân.
- Tệp PNG hình ảnh bản đồ thành phố Vastopolis (đọc thêm tệp README.DOC để rõ hơn về kích thước và tọa độ địa lý của bản đổ).
- Tệp DOC mô tả về dữ liệu.
Tổ chức tệp/thư mục với cấu trúc rõ ràng:
raw/,
processed/,
figures/,
reports/, v.v.
Thư mục raw/ chứa toàn bộ dữ liệu thô liệt kê bên trên.
2) Làm sạch & chuẩn hoá
Yêu cầu chung: Xây dựng bộ quy tắc đảm bảo chất lượng dữ liệu (QA) minh bạch; ưu tiên gắn cờ thay vì xoá dữ liệu; chuẩn hoá các kiểu dữ liệu như danh mục (vd. weather, wind-direction) và trường thời gian và trường vị trí địa lý (lat-long). Chuẩn hóa dữ liệu văn bản trong nội dung blog và keyword, ví dụ: xóa khoảng trắng dư thừa, chuyển về chữ thường hoặc chữ in hoa đồng nhất (normalcase / uppercase), v.v. Chú ý về encoding của các ký tự lưu trữ trong file ('utf-8', 'latin-1')
Ví dụ quy tắc phát hiện dữ liệu ngoại lệ: Không có trường thông tin text của bảng microblogs, không có thông tin vị trí địa lý của mỗi blog, không có thông tin thời tiết, hướng gió v.v.
Lưu kết quả:
Ghi báo cáo QA này vào reports/qa_summary.csv và mô tả rõ trong báo cáo PDF cuối cùng.
Lưu dữ liệu đã làm sạch/chuẩn hoá (ưu tiên CSV) vào processed/.
3) Tổng hợp dữ liệu
Yêu cầu chung:
* Yêu cầu 1: Nội suy (upsample) dữ liệu thời tiết lên tần suất theo giờ hoặc phút
và kết nối (join) với bảng dữ liệu microblogs thông qua
trường thời gian. Sau khi kết nối, thêm các cột
weather, wind_direction và average_wind_speed
vào bảng microblogs.
* Yêu cầu 2: Sử dụng danh sách từ khóa trong tệp keywords.txt để:
- Phân loại thủ công hoặc tự động các từ khóa thành hai nhóm bao gồm: các loại từ khóa liên quan đến
triệu chứng bệnh, bệnh việnví dụ: (stomach, flu, fever, caught, bad, medicine, feel, chills,...) và các loại từ khóakhác. - Thống kê số lần xuất hiện của mỗi từ khóa trên các blog theo giờ.
- Xác định kiểu thời tiết (weather) và hướng gió (wind_direction) phổ biến nhất cho từng từ khóa theo giờ.
* Yêu cầu 3: Ánh xạ vị trí địa lý (location): Thống kê các vị trí địa lý nơi xuất hiện từng
từ khóa theo từng khung giờ.
Ví dụ: từ khóa stomachache xuất hiện tại các vị trí
(40.34N - 93.30W), (41.32N - 92.15W), ... trong khoảng thời gian 10h–11h ngày
01/05/2011.
Lưu kết quả:
-
processed/keywords.csvCác cột gồm:symptom_keyword=> các từ khóa liên quan đến triệu chứng bệnh,other_keyword=> các từ khóa khác. -
processed/stat_hourly_HH_DD_MM.csv(trong đóHH_DD_MMlần lượt là giờ/ngày/tháng).
Các cột gồm:keyword,count,weather,wind_directionvà các cột tùy chọn khác để phân tích. -
processed/keyword_location_mapping_hourly_HH_DD_MM.csv
Gồm các cột:location(vị trí địa lý),keyword(từ khóa xuất hiện tại vị trí đó).
Giả sử có K₁, K₂, ..., Kₙ từ khóa, mỗi từ khóa xuất hiện tại N₁, N₂, ..., Nₙ vị trí trong một giờ, thì bảng này có tổng cộng N₁ + N₂ + ... + Nₙ hàng. Mỗi cặp (vị trí - từ khóa) là duy nhất (unique), nhưng cùng một vị trí hoặc từ khóa có thể lặp lại ở nhiều hàng khác nhau.
4) Trực quan hóa dữ liệu
Yêu cầu chung: Cần tạo 3–4 biểu đồ cho mỗi thống kê theo giờ (tức là thống kê và vẽ biểu đồ dữ liệu ở mức độ theo giờ).
Gợi ý biểu đồ:
-
Bắt buộc: Bản đồ phân bố các từ khóa liên quan đến triệu chứng bệnh theo từng giờ
(sử dụng bảng
keyword_location_mapping_hourly_...và bản đồVastopolis_Map.png), trong đó mỗi vị trí có từ khóa là một chấm, màu sắc khác nhau thể hiện từng từ khóa. - Biểu đồ cột so sánh (ví dụ: top khung giờ hoặc khu vực có số lượng từ khóa xuất hiện nhiều nhất).
- Biểu đồ đường theo thời gian (giờ/ngày/tháng) thể hiện xu hướng số lượng từ khóa liên quan đến triệu chứng bệnh.
- Trực quan hóa bằng thư viện wordcloud (ví dụ: từ khóa có số lượng lớn nhất theo khung giờ sẽ to lớn nhất và nằm ở trung tâm và bé dần theo số lượng của nó).
- Có thể sáng tạo thêm các biểu đồ khác để phân tích mối liên hệ giữa blog và thời tiết, ví dụ: tương quan giữa từ khóa và nhiệt độ, hoặc hướng gió với tần suất xuất hiện từ khóa.
Lưu kết quả: Lưu các hình vào thư mục figures/
với tên dễ tra cứu, ví dụ:
figures/keyword_count_overtime.png,
figures/pointmap_epidemic_symptoms_hourly_HH_DD_MM.png
Gợi ý về thống kê và trực quan hóa dữ liệu: 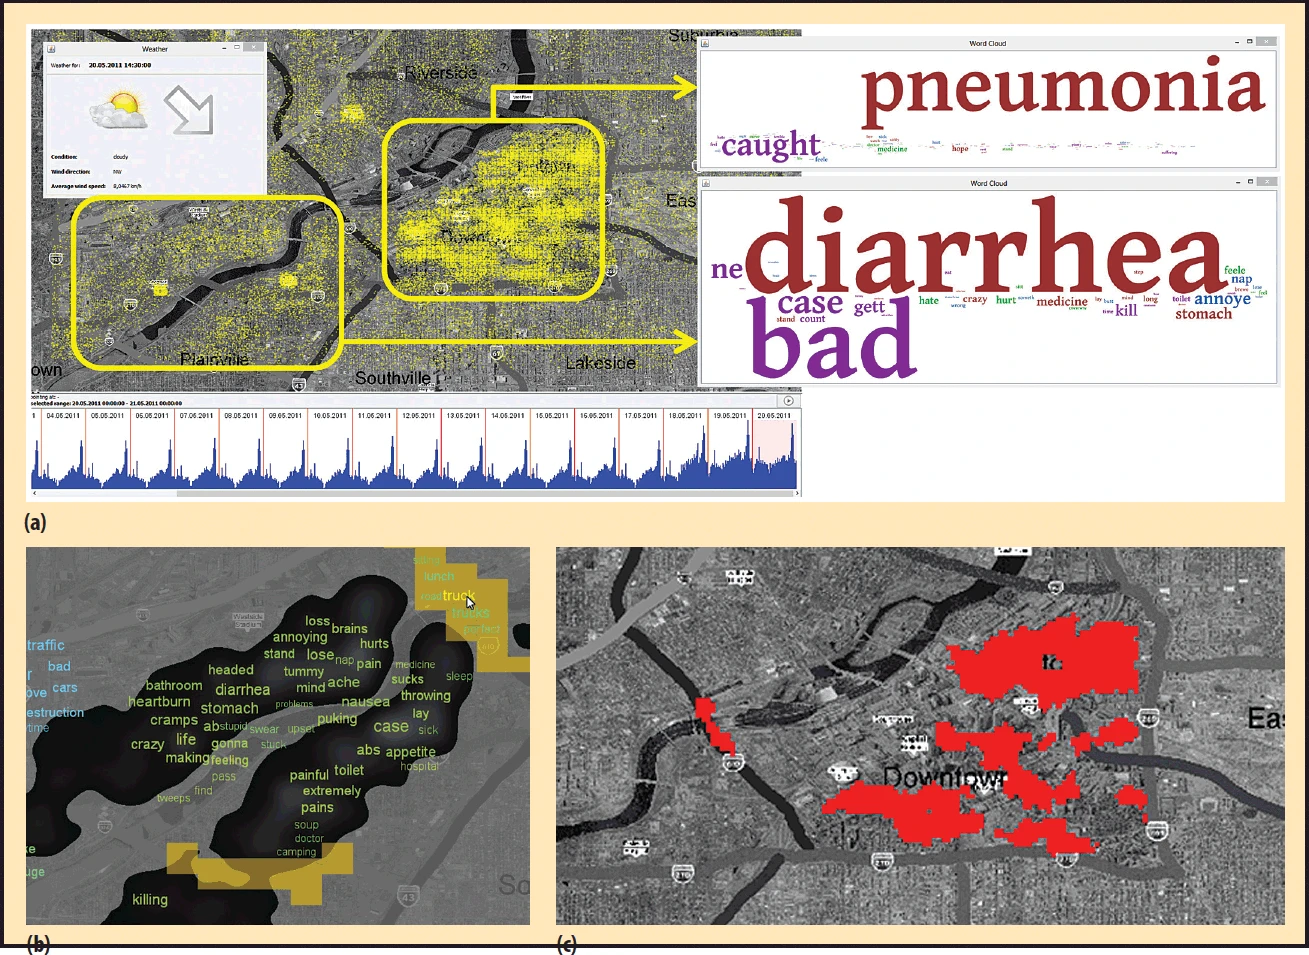
5) Diễn giải & kết luận
Yêu cầu chung: Trình bày phát hiện chính, thảo luận giới hạn và đề xuất tiếp theo.
Gợi ý:
- Tóm tắt 3–5 phát hiện đáng chú ý, kèm hình/bảng minh hoạ.
- Đề xuất cải tiến (thu thập, trích xuất thêm thông tin, sáng tạo thêm phương pháp visualize dễ hiểu hoặc phân tích mở rộng).
- Đưa ra dự đoán về thời điểm bùng phát dịch bệnh và các triệu chứng bệnh phổ biến nhất của từng khu vực => Từ đó bình luận về các con đường lây lan dịch bệnh (gợi ý: đường không khí, đường nước, ...).
Khuyến khích việc suy luận dựa trên nhiều kiểu hình thống kê và biểu đồ khác.
6) Viết báo cáo kỹ thuật
Yêu cầu chung: Viết báo cáo kỹ thuật (theo mẫu dưới đây) với
cấu trúc mạch lạc, tham chiếu
hình/bảng.
Báo cáo xuất ra PDF và lưu vào reports/report-<tên-nhóm>.pdf.
Riêng mã nguồn cần có README.md hướng dẫn chạy lại, công bố seed, có
requirements.txt.
7) Nâng cao (tuỳ chọn, điểm thưởng)
Yêu cầu chung: Thực hiện thêm 1–2 phân tích nâng cao để mở rộng kết quả chính. Ưu tiên cách làm đơn giản, minh bạch, tái lập (reproducible); nêu rõ mục tiêu, dữ liệu dùng, phương pháp và cách đánh giá. Phần này không bắt buộc, nếu đạt yêu cầu sẽ có điểm thưởng từ +5 đến +20.
Gợi ý hướng mở rộng:
- Đưa ra được phương án tạo ra file
keywords.csvgiống trong dữ liệu đề bài cho (đưa ra được thuật toán và cơ sở lý thuyết) và hướng mở rộng, cải tiến việc phân tích theo từ khóa cho hiệu quả hơn. - Phân tích tình hình dịch bệnh theo dòng thời gian dựa trên khối lượng từ khóa xuất hiện trên toàn bộ dữ liệu.
- Phân tích hướng lan truyền và cách dịch bệnh lan truyền.
- Tìm ra và phân tích nguồn gây ra dịch bệnh.
- Truy vết ngược và kết hợp với biểu đồ để kể lại câu chuyện về đại dịch ở thành phố Vastopolis trên toàn bộ dữ liệu.
- Phân cụm mẫu hình (k-means) cho khung giờ dựa trên vector keywords. Đặt tên cụm & mô tả đặc trưng.
Sản phẩm cần bàn giao
-
Mã nguồn (Notebook/script) chạy lại được toàn bộ pipeline: nạp → làm sạch/chuẩn hoá
→ tổng hợp → vẽ hình. Có chú thích rõ ràng từng bước ghi vào
README.md. Ghi toàn bộ các thư viện và phiên bản đã dùng vào filerequirements.txt(để có thể tái lập môi trường Python nhanh bằngpip install -r requirements.txt).
Cấu trúc thư mục đề xuất
. ├── raw/ # Dữ liệu thô ├── processed/ # Dữ liệu đã xử lý & bảng tổng hợp ├── figures/ # Hình trực quan hoá ├── reports/ # Báo cáo kỹ thuật ├── src/ # Jupyter Notebooks hoặc Python scripts ├── README.md # Hướng dẫn chạy lại └── requirements.txt # Thư viện & phiên bản -
Dữ liệu: bản thô (đã tải, ở
raw/) và bản đã xử lý (CSV ởprocessed/). -
Báo cáo kỹ thuật mô tả dữ liệu, quy tắc chất lượng,
KPI, kết quả và giới hạn, kèm hình/bảng minh hoạ, diễn giải kết quả.
Yêu cầu:- Dùng cấu trúc mẫu được cung cấp (xem bên dưới).
- Tuỳ chọn sử dụng LaTeX, Microsoft Word / Google Docs hoặc bất cứ phần mềm soạn thảo nào khác.
- Xuất file báo cáo ra
reports/report-<tên-nhóm>.pdf. - Tuỳ chọn: Có thể viết bằng tiếng Việt hoặc tiếng Anh.
Cấu trúc báo cáo kỹ thuật
- Thông tin cơ bản: tên dự án, tên nhóm, thành viên, năm dữ liệu, ngày nộp, commit hash được dùng để xác định phiên bản mã nguồn sẽ chấm.
- Giới thiệu & tổng quan dữ liệu: nguồn, phạm vi, đặc điểm chính.
- Làm sạch & chuẩn hoá: tác động, chuẩn hoá danh mục/thời gian.
- Tổng hợp &: định nghĩa, công thức, đơn vị, bảng tổng hợp.
- Trực quan hoá: hình minh hoạ với chú thích đầy đủ.
- Các phân tích nâng cao (nếu có): mục tiêu, phương pháp, đánh giá, diễn giải.
- Diễn giải & kết luận: phát hiện chính, bối cảnh, giới hạn, đề xuất tiếp theo.
- Tham khảo: liệt kê tài liệu, trang web, thư viện đã dùng.
Đóng dấu nộp bài: Tạo Git tag hoặc Release trước deadline và ghi rõ
commit hash được chấm trong báo cáo.
README.md.
Cách tính điểm
| Hạng mục | Mô tả | Điểm |
|---|---|---|
| Thu thập dữ liệu | Ghi nguồn & phiên bản dữ liệu; tổ chức tệp/thư mục rõ ràng. | 10 |
| Làm sạch & chuẩn hoá | Quy tắc đảm bảo chất lượng dữ liệu (QA) hợp lý (keywords, thời gian, thời tiết, hướng gió, ...); gắn cờ & báo cáo tác động; chuẩn hoá danh mục & thời gian. | 20 |
| Bảng tổng hợp & KPI | Định nghĩa rõ công thức/đơn vị; lưu bảng đúng định dạng. | 20 |
| Trực quan hoá | Tiêu đề, trục, đơn vị, chú giải đầy đủ; thông điệp rõ ràng; nhất quán phong cách. Bản đồ vẽ chính xác vị trí, rõ ràng, dễ hiểu | 20 |
| Diễn giải & kết luận | Nêu phát hiện chính và bối cảnh; thảo luận giới hạn dữ liệu & đề xuất tiếp theo. | 10 |
| Viết báo cáo & tái lập | Cấu trúc mạch lạc; tham chiếu hình/bảng; README & hướng dẫn chạy lại; công bố seed, requirements, và liên kết repo; tổ chức repo rõ ràng. | 10 |
| Trình bày báo cáo và vấn đáp | Trình bày mạch lạc, rõ ràng; trả lời câu hỏi; thảo luận quy trình & kết quả dự án. | 10 |
| Điểm thưởng (tuỳ chọn) | Phân tích nâng cao: Suy luận, phân tích dự đoán theo thời gian về nguyên nhân, hướng lan truyền, nguyên nhân lan truyền, kể lại câu chuyện theo dòng thời gian của diễn biến sử dụng biểu đồ | +0 đến +20 |